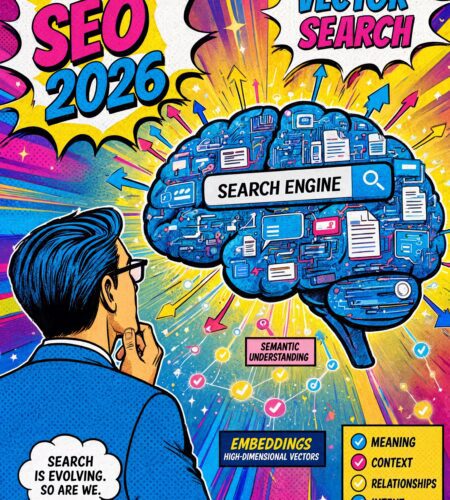
Et si, demain matin, votre page la mieux classée n’apparaissait plus nulle part… tout simplement parce qu’un modèle a préféré trois phrases d’un concurrent moins connu ? En 2026, la recherche ne se contente plus d’aligner dix liens bleus. Elle assemble une réponse. Elle découpe, compare, extrait, reformule. Le SEO 2026 n’est plus seulement une affaire de mots-clés : c’est une affaire de passages, de vecteurs et de logique sémantique. Pour les fondateurs, les marketeurs et les équipes produit, le sujet n’est plus théorique. Il décide qui est cité, qui est oublié, et qui continue d’exister quand l’utilisateur n’ouvre plus votre site.
Le basculement a un nom que l’on croise partout : AEO (Answer Engine Optimization) et GEO (Generative Engine Optimization). Derrière les acronymes, une réalité assez simple. Les systèmes génératifs ne « visitent » plus le web comme un annuaire. Ils le lisent comme un espace de significations, projeté dans des embeddings. Une page moyenne avec une section limpide peut être extraite. Une belle page sans respiration peut rester invisible. C’est ce retournement que les équipes doivent intégrer, sans jeter quinze ans de métier à la poubelle.
Pourquoi Les Anciennes Recettes Ne Tiennent Plus Toute Seules
Ceux qui font du référencement depuis longtemps ont déjà survécu à Panda, Penguin, RankBrain. Chaque vague a changé un levier. Celle-ci change la nature de la requête. L’utilisateur ne cherche plus uniquement un document. Il veut une synthèse, un arbitrage, une liste de critères, parfois une décision. Gemini et les autres modèles ne voient plus le web comme une pile de fichiers HTML. Ils le voient comme un espace sémantique vectoriel.
Dans beaucoup d’équipes, deux réflexes cohabitent encore. Le premier empile les occurrences d’une expression et croise les doigts. Le second se demande comment un modèle va découper la page, la vectoriser, puis réutiliser un extrait dans une réponse. En 2026, le second l’emporte. Pas parce que les mots-clés ont disparu. Parce qu’ils ne suffisent plus à gagner la sélection des passages.
Ce n’est plus seulement l’algorithme qui évolue. C’est la nature même de la recherche.
– Antonin Pasquereau
Le risque, pour une startup ou une PME, n’est pas seulement de perdre une position. C’est de perdre le rôle de source. Quand la réponse se construit sans clic, la marque qui n’est pas extractible n’existe plus dans le moment de décision. Le zéro clic n’est plus un accident de parcours. C’est le format par défaut de nombreuses intentions.
Le Netlinking Ne Meurt Pas, Il Change De Quartier
Les PBN et les annuaires n’ont pas disparu. Ils rapportent simplement de moins en moins, pour un risque qui, lui, n’a pas baissé. Ce qui tient dans la durée, c’est un lien posé dans un paragraphe qui traite vraiment le sujet, entouré d’entités identifiables : une marque, une ville, un nom propre, un chiffre daté, un produit nommé.
La raison est mécanique. Quand un moteur découpe une page en passages pour les vectoriser, un lien coincé dans un pied de page ou une liste de partenaires se retrouve dans un fragment qui ne parle de rien. Le même lien, placé au milieu d’un développement argumenté, hérite du contexte de ce développement. La Domain Authority n’est pas morte. Elle est devenue un critère parmi d’autres, et plus le premier.
Pour une équipe acquisition, cela change le brief. On ne chasse plus « un lien ». On chasse un contexte éditorial assez dense pour qu’un passage soit autonome. Un article de fond chez un média métier, une étude citée avec méthode, un retour d’expérience chiffré : ces formats portent mieux qu’un échange de banners. Le lien n’est plus un vote isolé. C’est un signal sémantique collé à un bloc de sens.
Les Données Structurées Aident, Mais Pas Comme On Le Raconte
Google a été explicite en juillet 2026 : aucun balisage particulier n’est exigé pour apparaître dans AI Mode ou dans les AI Overviews. Pas de schema magique. La seule exigence sérieuse, c’est la cohérence : les données structurées doivent correspondre au contenu visible. Mentir au balisage, c’est se tirer une balle dans le pied.
Ce qui compte vraiment, c’est la structure du contenu lui-même. Un tableau comparatif. Une définition en deux phrases. Une liste de critères. Ce sont des blocs autonomes, extraits et cités avec peu de reformulation. Un pavé de 800 mots sans respiration ne donne aucune prise. Le test est simple : sortez n’importe quel paragraphe de son contexte. S’il reste compréhensible, il est exploitable.
Les équipes qui réussissent traitent désormais chaque H3 comme une mini-unité de réponse. Titre clair. Réponse immédiate. Preuve ensuite. Sources ou chiffres. Fermeture. Ce n’est pas du « contenu pour robots ». C’est du contenu que l’humain peut scanner et que le modèle peut citer sans trahir le sens.
Entre La Requête Et Votre Page : Nlr, Rag Et Embeddings
La recherche classique associait une requête à des documents. Le fonctionnement actuel passe souvent par du RAG : la requête devient un vecteur, comparé à des passages eux-mêmes vectorisés en amont, et les meilleurs candidats servent de matière première à une réponse générée. La similarité vectorielle a remplacé le TF-IDF comme mesure de proximité dominante.
Le détail qui change tout : ce ne sont plus seulement des pages qui sont sélectionnées. Ce sont des passages. Une page moyenne avec une excellente section peut être citée. Une bonne page sans section nette peut ne jamais l’être. D’où l’obsession nouvelle pour la granularité. On n’écrit plus seulement « un article de 2 000 mots ». On conçoit une collection de modules sémantiques.
Pour les marketeurs, cela implique un autre regard sur le brief. Au lieu de demander « un texte sur l’ERP », on demande : quels faits autonomes voulons-nous rendre citables ? Quel tableau peut être extrait tel quel ? Quelle définition tient en deux phrases ? Quelles entités doivent apparaître pour ancrer le passage dans un graphe ?
Le Query Fan-Out, Ou Comment Une Question Se Multiplie
Posez « quel ERP pour une PME ? » et le système ne cherche pas seulement cette phrase. Il lance en parallèle une série de recherches dérivées : budget, fonctionnalités, intégration, support, sécurité. Chacune ramène ses propres passages. La réponse finale assemble des sources qui n’ont jamais été classées ensemble sur une page de résultats classique.
La conséquence est directe pour la production. Une page qui ne traite que la question de surface ne participe qu’à une fraction du fan-out. Il faut couvrir les sous-questions, une par titre, avec la réponse dans les deux premières phrases et les preuves ensuite. C’est ce que certains appellent une Fan-Out Embedding Expansion : la requête explose, chaque fragment cherche son jumeau vectoriel, puis tout est recomposé.
Concrètement, un bon article 2026 ressemble moins à une dissertation qu’à un dossier. Chaque sous-intention a son module. Chaque module peut vivre seul. L’ensemble reste cohérent pour le lecteur humain, qui n’a jamais disparu. On n’écrit pas « pour l’IA contre l’humain ». On écrit pour les deux destinataires en même temps.
Une Parenthèse Utile Sur Llms.Txt
La question revient à chaque réunion, autant la traiter sans folklore. Google ignore le fichier : sa documentation de juillet 2026 indique qu’il n’aide ni ne pénalise, y compris dans les fonctionnalités génératives. Les études d’adoption disponibles ne montrent aucun effet mesurable sur les citations. Rien n’empêche de le publier si un agent identifié l’exploite. Mais pas au détriment de l’indexabilité, du maillage ou du contenu.
Autrement dit : llms.txt n’est pas une stratégie. C’est, au mieux, un accessoire. Les équipes qui y consacrent plus d’énergie qu’à clarifier leurs passages font le mauvais arbitrage. Les modèles citent ce qu’ils comprennent, pas ce qu’un fichier leur ordonne poliment de comprendre.
Du Document Au Passage : La Granularité Comme Critère
Aujourd’hui, les systèmes génératifs ne se contentent plus de choisir des pages entières. Ils se concentrent sur des unités plus petites. Pour qu’une unité soit efficace, elle doit présenter une information claire, être bien structurée, et être liée à des entités reconnaissables : personnes, marques, lieux, produits, normes, dates.
- Un fait, une date ou un nom propre clairement énoncé
- Une structure scannable : définition, liste, tableau, critère
- Des entités stables que l’on peut relier à un graphe
- Une réponse dès les premières phrases du bloc
- Des preuves ensuite : chiffres, méthode, limites
C’est pourquoi l’on envisage désormais le contenu comme une série de modules sémantiques plutôt que comme de simples articles linéaires. Un module n’est pas un gadget de design. C’est une unité de récupération. S’il se tient tout seul, il peut voyager dans une réponse. S’il dépend de trois paragraphes précédents pour avoir un sens, il reste prisonnier de la page.
Quand L’ia Reformule Vos Questions Avant Même De Chercher
Reprenons l’exemple : « Quel ERP pour une PME ? » Le système décompose. Budget. Fonctionnalités. Support. Sécurité. Intégration. Chaque sous-question est vectorisée, comparée à des passages pertinents, puis intégrée dans un prompt contextuel. Le résultat est une réponse composite, provenant de multiples sources, qui reste cohérente en surface.
Pour une marque, cela crée une nouvelle concurrence. Vous ne rivalisez plus seulement avec la page qui cible la même requête principale. Vous rivalisez avec le meilleur passage « budget », le meilleur passage « sécurité », le meilleur passage « intégration ». Un éditeur ultra-spécialisé peut vous souffler une citation sans jamais viser votre mot-clé tête.
La parade n’est pas d’écrire plus long pour le plaisir. C’est de cartographier les sous-intentions avant de rédiger. Quelles objections un acheteur pose-t-il vraiment ? Quels critères un modèle va-t-il chercher pour assembler une comparaison ? Quels chiffres datés rendent un passage plus crédible qu’une généralité ?
L’ingénierie De La Pertinence, Nouvelle Discipline Du Métier
Le métier évolue. L’expert SEO se transforme en architecte de la donnée sémantique. Il n’écrit plus seulement pour le lecteur. Il écrit aussi pour un modèle qui découpe. Il collabore avec des graphes de concepts, des encodeurs de phrases, des formats facilement identifiables : tableaux, listes, définitions.
Le contenu prêt pour l’IA est un contenu modulaire, structuré, basé sur des entités et vectorisable. Cela ne signifie pas qu’il faut jeter le style. Un texte plat et correct mais sans voix ne retient personne. Un texte brillant mais impossible à extraire ne voyage pas. Le travail 2026 consiste à tenir les deux exigences sans les caricaturer.
Le fond du travail n’a pas tellement bougé en quinze ans : écrire des choses vraies, vérifiables et bien rangées. Ce sont les destinataires qui ont changé.
– Antonin Pasquereau
Les outils suivent : graphes de concepts, encodeurs de phrases, simulateurs RAG. Ce sont des accessoires. Ils aident à voir ce qu’un modèle rapproche. Ils ne remplacent pas le jugement éditorial. Une startup qui achète trois outils sans changer sa façon d’écrire des blocs n’a rien résolu.
Requêtes Personnalisées Et Profils Utilisateurs Vectorisés
Le SEO pour les LLM devient personnel. Deux utilisateurs différents ne reçoivent pas les mêmes réponses, parce que leur embedding utilisateur influence la recherche : historique, géolocalisation, comportement, préférences. La page « unique et universelle » perd du terrain face à des réponses situées.
La stratégie doit donc se concentrer sur des territoires sémantiques cohérents : être présent sur les entités clés, dans des formats pertinents, pour plusieurs types de profils. Une scale-up B2B n’écrit plus seulement pour « le directeur marketing ». Elle écrit des modules pour le DAF qui regarde le coût total, pour l’ops qui regarde l’intégration, pour le juridique qui regarde la conformité.
Ce n’est pas du content marketing décoratif. C’est de l’architecture d’information. Quelles entités doivent apparaître ? Sous quel format ? Dans quel ordre ? Appuyées par quelles preuves ? Plus le territoire est cohérent, plus les passages d’un même site se renforcent les uns les autres dans l’espace vectoriel.
Ce Que Change Concrètement Un Brief De Contenu En 2026
Un brief utile ne se limite plus à un mot-clé, un volume et un nombre de mots. Il décrit des unités. Il liste les sous-questions du fan-out. Il impose une réponse dès l’ouverture de chaque section. Il exige des entités nommées. Il prévoit au moins un bloc extractible : tableau, définition, checklist, comparatif.
Il demande aussi des limites. Un passage trop sûr de lui, sans nuance, est fragile. Les modèles aiment les formulations nettes, mais les lecteurs humains, surtout en B2B, sanctionnent l’esbroufe. La bonne tension : une phrase d’ouverture claire, puis le détail, puis ce que l’on ne sait pas encore.
Les rédactions qui s’en sortent traitent chaque page comme un produit. On itère. On observe quels extraits sont repris. On renforce les modules cités. On réécrit ceux qui restent flous. Le calendrier éditorial n’est plus une file d’articles. C’est un inventaire de passages à améliorer.
Comment Observer Sa Présence Dans Ai Mode Sans Se Mentir
Mesurer la visibilité générative reste artisanal. Ce n’est pas une raison pour ne rien faire. On peut tester les mêmes requêtes avec différents profils : navigation privée, session connectée, localisations distinctes. On observe les passages repris. On note les sources concurrentes qui reviennent. On compare la formulation de la réponse à ses propres modules.
- Tester les requêtes avec plusieurs profils (incognito, compte actif, contextes différents)
- Repérer les extraits repris dans les modes génératifs
- Simuler un pipeline RAG pour voir quels passages remontent
- Travailler les embeddings de contenu et vérifier la proximité sémantique
- Relier chaque citation manquée à un module trop flou ou trop tardif
Des stacks comme LangChain, RAGStack ou LlamaIndex aident à reproduire un comportement de récupération. Des encodeurs de phrases aident à voir si deux formulations proches dans votre tête le sont aussi dans l’espace vectoriel. L’objectif n’est pas de « hacker Gemini ». C’est de réduire l’écart entre ce que vous croyez avoir dit et ce qu’un modèle peut extraire.
Ce Qui Reste Humain Dans Un Web Vectorisé
Il serait confortable de conclure que tout est devenu technique. Ce n’est pas vrai. Les modèles récompensent encore la clarté, la vérifiabilité, la spécificité. Une anecdote datée, un chiffre sourcé, un nom d’outil réel, une limite avouée : ces éléments ancrent un passage. Le vague, lui, se noie.
Les startups qui gagnent du terrain en 2026 ne sont pas forcément celles qui publient le plus. Ce sont celles qui documentent leur terrain avec assez de précision pour devenir une source. Elles acceptent de traiter des sous-questions « moins glamour » : coût d’implémentation, support, sécurité, bascule de données. Ce sont souvent ces modules-là qui alimentent le fan-out.
Le référenceur passe une part croissante de son temps sur l’architecture. Quelles entités. Quel ordre. Quelles preuves. Les outils aident. Le métier, au fond, reste de ranger des choses vraies de façon utilisable. Seulement, les destinataires se sont multipliés : le lecteur pressé, le modèle qui découpe, le système qui assemble.
Une Feuille De Route Sobre Pour Les Équipes Marketing
Si vous dirigez une équipe de cinq personnes, vous n’avez pas besoin d’un manifeste. Vous avez besoin d’un ordre de priorités. D’abord, inventoriez vos pages qui visent des intentions à fort enjeu. Ensuite, découpez-les en modules. Puis réécrivez les ouvertures. Ajoutez un bloc extractible. Nommez des entités. Datez ce qui peut l’être. Reliez les preuves au propos, pas en bas de page orpheline.
Ensuite seulement, discutez netlinking. Un lien dans un passage pauvre reste un signal faible. Un lien dans un développement argumenté voyage avec son contexte. La même logique vaut pour les relations presse et le guest content : le voisinage sémantique compte autant que le nom de domaine hôte.
Enfin, acceptez que la mesure soit imparfaite. Comptez les citations observées. Notez les formulations reprises. Identifiez les sous-questions où vous êtes absents. Traitez ces absences comme des tickets produit, pas comme une fatalité algorithmique. Le SEO 2026 récompense les équipes qui itèrent sur la matière, pas celles qui commentent les mises à jour.
Ce Que Les Fondateurs Doivent Retenir Sans Jargon
Vos pages ne sont plus seulement des destinations. Ce sont des réserves de fragments. Si un fragment n’est pas clair, il ne partira pas dans la réponse. Si votre offre n’est pas liée à des entités que le marché reconnaît, elle flotte. Si vous ne couvrez que la question de surface, le fan-out ira chercher ailleurs le budget, la sécurité, l’intégration.
Investir dans le contenu reste rationnel. À condition d’investir dans la forme utile de ce contenu. Moins de textes interchangeables. Plus de modules sourcés. Moins de balisage magique. Plus de cohérence entre ce qui est visible et ce qui est déclaré. Moins de files d’attente d’articles. Plus de réécriture des passages qui comptent.
Le web n’a pas disparu. Il a changé de mode d’emploi. Ceux qui le traitent encore comme une collection de classements hebdomadaires rateront la partie où la marque est citée sans être cliquée… et parfois, ensuite, cliquée parce qu’elle a d’abord été citée.
Conclusion : Ranger Le Vrai Pour Qu’il Puisse Voyager
Le SEO 2026 n’annule pas le référencement. Il le déplace vers l’ingénierie de la pertinence. Vectorisation, RAG, fan-out, profils utilisateurs : le vocabulaire impressionne. Le geste, lui, reste accessible. Écrire des blocs autonomes. Les ancrer dans des entités. Les prouver. Les ranger. Les tester dans les interfaces génératives. Recommencer.
Les anciennes méthodes ne sont pas toutes mortes. Elles sont incomplètes. Le mot-clé aide encore à cadrer. Le lien aide encore à situer. Le schema aide encore à clarifier, s’il dit vrai. Mais la sélection se joue désormais au niveau du passage. C’est là que les équipes marketing, produit et contenu doivent se rejoindre, sans théâtre et sans file d’attente de tactiques miracles.
Si vous ne retenez qu’une question pour la semaine prochaine, que ce soit celle-ci : si l’on extrait n’importe lequel de nos paragraphes, reste-t-il utilisable ? Quand la réponse est non, le travail commence. Quand elle devient souvent oui, vous n’avez pas « hacké l’IA ». Vous avez simplement rendu votre savoir transportable. Et c’est exactement ce que la recherche générative récompense.
Abonnez-vous à notre newsletter pour recevoir les derniers articles directement dans votre boîte mail.
Commentaires